
Budget alert, 就是設定一個預算基準, 常見金額可能是每個月100美金 或是1000台幣, 預設會分成三次觸發分別在 50%, 80% 100% 寄送通知到指定的mail通知當前花費已經超過設定的這三個水平
這裡還可以設定一種預測花費的通知, 如
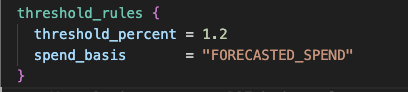
就會在到達120%的門檻時, 把預測這個月的總花費在通知中告知, 沒設定的話則是以當前已經產生的當月花費來通知
此外, 雖然CX agent studio有獨立於GCP console的操作介面, gcp仍然是以project來當作計費對象, 只要agent屬於同一個project, 就可以在billing看到統整的計費, 不用分開兩個站台看
Cloud run的冷啟動是指在沒有流量下, 就會把instance砍掉
直到有請求進來 會經歷:pull image → 啟動容器 → 完成app import/初始化 → 建立VPC connector → 處理請求 而這整段延遲就是 “冷啟動”
有幾個比較常見做法
1. startup_cpu_boost = true(免費)
容器啟動階段臨時給更多 CPU,加速 Python import、FastAPI 初始化等過程。只在啟動那幾秒生效,不影響運行時計費,是幾乎沒有代價的第一步。
2. 精簡啟動路徑(免費)
比如把 CES client、Firebase Admin SDK 這類重的初始化改成 lazy load(真正收到第一個請求才建立),或者瘦身 Docker image(multi-stage build、用 slim base image),減少 pull + import 的時間。
3. min_instance_count = 1(要付錢,效果最直接)
讓 Cloud Run 永遠保留至少一個熱實例,徹底消滅冷啟動,但代價是這個實例 24 小時計費,不再享受 scale-to-zero 的省錢優勢。
4. 調高 max_instance_request_concurrency
讓一個熱實例能同時扛更多請求,降低「因為流量突增而需要新開一個冷實例」的頻率——這個是減少冷啟動發生的次數,不是讓單次冷啟動變快。
5.(較進階)VPC Connector 換成 Direct VPC egress
新版 Cloud Run 支援不透過 Serverless VPC Access Connector、直接用 Direct VPC egress 連 VPC,理論上網路路徑建立更快,可以省掉冷啟動裡網路那段的延遲。
1,2 都可以比較容易達成
3,4基本上就是放棄讓instance歸零的策略,
5則是針對connector的修改
實際上可以先做1,2 然後依測試結果考慮3-5是否要採用


 iThome鐵人賽
 看影片追技術